Dokumentextraktion
Die Read-File-Komponente kann die Dateiverarbeitung an einen KARLI-Dokumentextraktions-Dienst delegieren und so strukturierte Extraktion aus Dokumenten und Audio mittels spezialisierter Modelle ermöglichen. Zwei entfernte Backends stehen zur Verfügung: karli (das KARLI-Backend vor AISL) und aisl (das Gateway des AI Service Layer).
Extraktions-Backend
Das Dropdown Extraction Backend der Komponente legt fest, wie Dateien verarbeitet werden:
| Backend | Verhalten |
|---|---|
docling (Standard) |
Dateien werden lokal über die Upstream-Langflow-/Docling-Pipeline verarbeitet. |
karli |
Dateien werden an den KARLI-Extraktionsdienst gesendet, der strukturierte Inhalte zurückgibt. |
aisl |
Dateien werden vom KARLI-(AISL)-Gateway als asynchroner Job extrahiert. Erfordert Object Storage — siehe unten. |
Modellauswahl
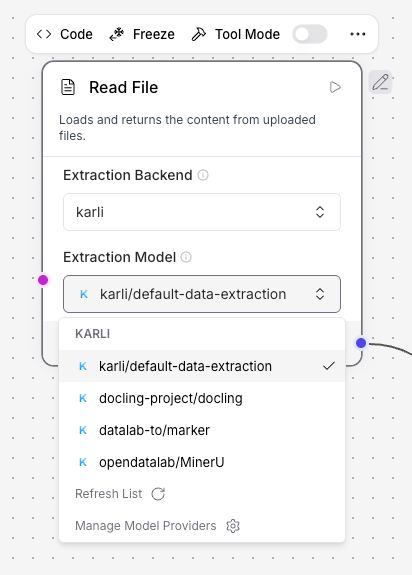
Steht Extraction Backend auf karli, erscheint zusätzlich das Feld Model. Das Dropdown wird dynamisch vom KARLI-Provider befüllt — KARLI ist derzeit der einzige Anbieter von Datenextraktions-Modellen.
Unter Modelle → Datenextraktion findet sich die vollständige Modellliste samt akzeptierter Dateitypen. Die Komponente prüft die hochgeladene Datei vor dem Upload gegen den akzeptierten Typ des gewählten Modells (ein PDF an das Whisper-Modell zu schicken, liefert z. B. einen Fehler statt eines Uploads).
Authentifizierung
Ist das karli-Backend gewählt, authentifizieren sich Extraktions-Requests mit folgender Priorität:
- JWT (bei aktiver Karli-Studio-Session) — gesendet als
Authorization: Bearer <token>. KARLI_API_KEY(aus Komponentenattribut, Provider-Variablen oder der UmgebungsvariableKARLI_API_KEY) — gesendet alsX-API-Key: <key>.- Fehler — sind weder JWT noch Key verfügbar, wird ein
ValueErrorausgelöst mit dem Hinweis,KARLI_API_KEYzu konfigurieren oder über Karli Studio zuzugreifen.
Info
KARLI_API_KEY ist nur relevant beim direkten Zugriff auf die Agentlab-API ohne Karli-Studio-Session. Studio-Nutzer müssen dieses Feld nicht konfigurieren. Siehe die Model-Provider-Übersicht für Details zu den Zugangsdaten.
Ablauf
Ist die Extraktion aktiviert, reicht die Komponente die Datei per Multipart-POST an {KARLI_BASE_URL}/data-extraction/submit als asynchronen Task ein. Das Formularfeld extractorModel trägt das gewählte Modell (gemappt auf seinen KARLI-Identifier), der File-Part enthält das Dokument. Danach folgt die Komponente dem Task, bis er fertig ist; mit karli/data-extraction-moe-latest meldet sie dabei den Fortschritt (siehe Fortschrittsmeldung). Der fertige Task liefert ein JSON-Ergebnis, deren segments zu einem Text zusammengefügt werden — Segmente mit title erscheinen als ## <title>-Markdown-Überschriften.
flowchart LR
    Upload["Datei-Upload"] --> RF["Read File"]
    RF --> KES["KARLI-Extraktionsdienst"]
    KES --> Out["Strukturierte Ausgabe"]
Der Output nach unten ist ein Data mit:
| Feld | Beschreibung |
|---|---|
file_path |
Ursprünglicher lokaler Pfad der hochgeladenen Datei. |
exported_content |
Der zusammengesetzte Text (mit ## <title>-Überschriften pro Segment). |
export_format |
Für dieses Backend stets KARLI. |
task_id |
Die Task-ID des KARLI-Extraktionsauftrags — nützlich für Tracing. |
model |
Der Identifier des verwendeten Modells. |
Zusammenfassung der Einstellungen
| Einstellung | Beschreibung |
|---|---|
| Extraction Backend | docling (lokal), karli (KARLI-Dienst) oder aisl (AI Service Layer). |
| Model | Nur sichtbar, wenn das karli- oder aisl-Backend aktiv ist. |
KARLI-(AISL)-Backend
Das Backend aisl leitet die Extraktion über das Gateway des AI Service Layer des Providers KARLI (AISL). Wie KARLI führt es die Extraktion als asynchronen Job aus, ermittelt die verfügbaren Dienste aber zur Laufzeit, statt sie fest zu hinterlegen.
Modellauswahl
Mit aisl listet das Dropdown Model die docparse-Dienste des Gateways, live gelesen von {AISL_BASE_URL}/api/v1/services?type=docparse. Neue Dienste erscheinen, sobald das Gateway sie meldet — ohne Agentlab-Update. Ist das Gateway nicht erreichbar, wird eine kleine mitgelieferte Ersatzliste angezeigt.
Anders als beim karli-Backend gibt es keine Übersetzungstabelle für Modellnamen: Die Dienst-ID ist der Modellname und wird direkt für den Process-Endpunkt verwendet.
Voraussetzung Object Storage
Erfordert LANGFLOW_STORAGE_TYPE=s3
Die docparse-API lädt das Dokument selbst über eine input_url, statt einen Upload entgegenzunehmen. Agentlab stellt dafür eine 15 Minuten gültige, vorsignierte URL bereit — das kann nur Object Storage leisten. Auf Instanzen mit lokalem Dateispeicher bricht die Komponente mit einem Hinweis auf diese Einstellung ab; dort stattdessen das docling-Backend oder den Provider karli verwenden.
Authentifizierung
Dieselbe Reihenfolge wie beim karli-Backend, jedoch mit einem einzigen Schlüssel und durchgängig als Bearer-Token:
- JWT (bei aktiver Karli-Studio-Session) — gesendet als
Authorization: Bearer <token>. AISL_API_KEY(aus dem Komponenten-Attribut, den Provider-Variablen oder der Umgebungsvariable) — gesendet alsAuthorization: Bearer <key>.- Fehler — ist beides nicht vorhanden, schlägt die Extraktion mit einem Hinweis auf
AISL_API_KEYfehl.
Ablauf
flowchart LR
    Upload["Datei-Upload"] --> RF["Read File"]
    RF --> S3["Object Storage
(vorsignierte URL)"]
    RF --> Submit["POST /api/v1/{service}/process/async"]
    Submit --> Poll["GET /api/v1/jobs/{id}"]
    Poll --> Result["GET /api/v1/jobs/{id}/result"]
    S3 -.abgerufen von.-> Submit
    Result --> Out["Strukturierte Ausgabe"]
Agentlab erzeugt eine vorsignierte URL für die Datei, startet den Job mit output_format: markdown, fragt den Status bis zu einem Endzustand ab und holt anschließend das Ergebnis. Ein fehlgeschlagener oder nicht binnen 10 Minuten beendeter Job erscheint als Fehler am Komponenten-Ausgang statt als Exception.
Das nachgelagerte Data enthält dieselben Felder wie beim karli-Backend, mit folgenden Abweichungen:
| Feld | Wert |
|---|---|
export_format |
KARLI (AISL) |
task_id |
Die docparse-Job-ID. |
model |
Die docparse-Dienst-ID (z. B. docparse-marker). |